ORIGA, LA PUISSANCE DE L’IA GÉNÉRATIVE AU SERVICE DES ESSAIS CLINIQUES ET DES ALGORITHMES MÉDICAUX

ORIGA est la première plateforme web européenne d’augmentation des données cliniques par deep learning. Elle permet aux industriels de la santé et aux chercheurs de générer des patients artificiels réalistes, tout en garantissant la confidentialité des données et la conformité réglementaire.

LES ESSAIS CLINIQUES À L’ÉPREUVE DE LA RÉALITÉ

Les essais cliniques sont essentiels pour faire avancer la recherche médicale, valider l’efficacité d’un traitement ou encore améliorer la prise en charge des patients. Mais sur le terrain, les défis sont nombreux :

  • Recrutement patient lent et coûteux
  • Accès restreint à des données de qualité, parfois incomplètes ou sensibles
  • Règlementations strictes (RGPD, IA Act) qui limitent l’usage et le partage des données réelles
  • Manque de représentativité de certaines populations dans les cohortes

Face à ces limites, les chercheurs et industriels de la santé ont besoin d’outils innovants, fiables et conformes pour aller plus loin, plus vite — sans jamais compromettre la confidentialité des patients.

NOTRE SOLUTION ORIGA


ORIGA est une plateforme web d’augmentation de données cliniques conçue pour générer des patients artificiels réalistes, tout en garantissant un haut niveau de sécurité et de conformité.

Elle repose sur trois fonctionnalités clés :

L’augmentation des données avec ORIGA consiste à enrichir vos jeux de données existants par la génération de nouvelles données artificielles réalistes. Cette technique améliore la robustesse et les performances des modèles d’intelligence artificielle, notamment pour l’entraînement d’algorithmes médicaux et dans la réalisation d’essais cliniques où les données réelles disponibles peuvent être limitées.

ORIGA assure l’anonymisation complète de vos données sensibles en générant des données artificielles réalistes, tout en protégeant efficacement la confidentialité des patients. Ainsi, vous pouvez partager ou exploiter des données sans aucun risque de ré-identification, facilitant la conformité réglementaire.

L’imputation des données par ORIGA consiste à compléter des jeux de données incomplets ou manquants à l’aide de données artificielles cohérentes avec votre population originale. Cette méthode améliore la qualité de vos données et assure la fiabilité des analyses, particulièrement essentielle dans le contexte d’essais cliniques.

LES VAE, C’EST QUOI EXACTEMENT ?

ORIGA s’appuie sur des modèles avancés d’IA générative appelés Variational Autoencoders (VAEs), développés en partenariat avec la Professeure Stéphanie Allassonnière, experte du domaine.

Les VAEs permettent de :

  • Apprendre la structure profonde des données cliniques (même complexes ou déséquilibrées)
  • Générer de nouveaux patients statistiquement cohérents, mais totalement fictifs
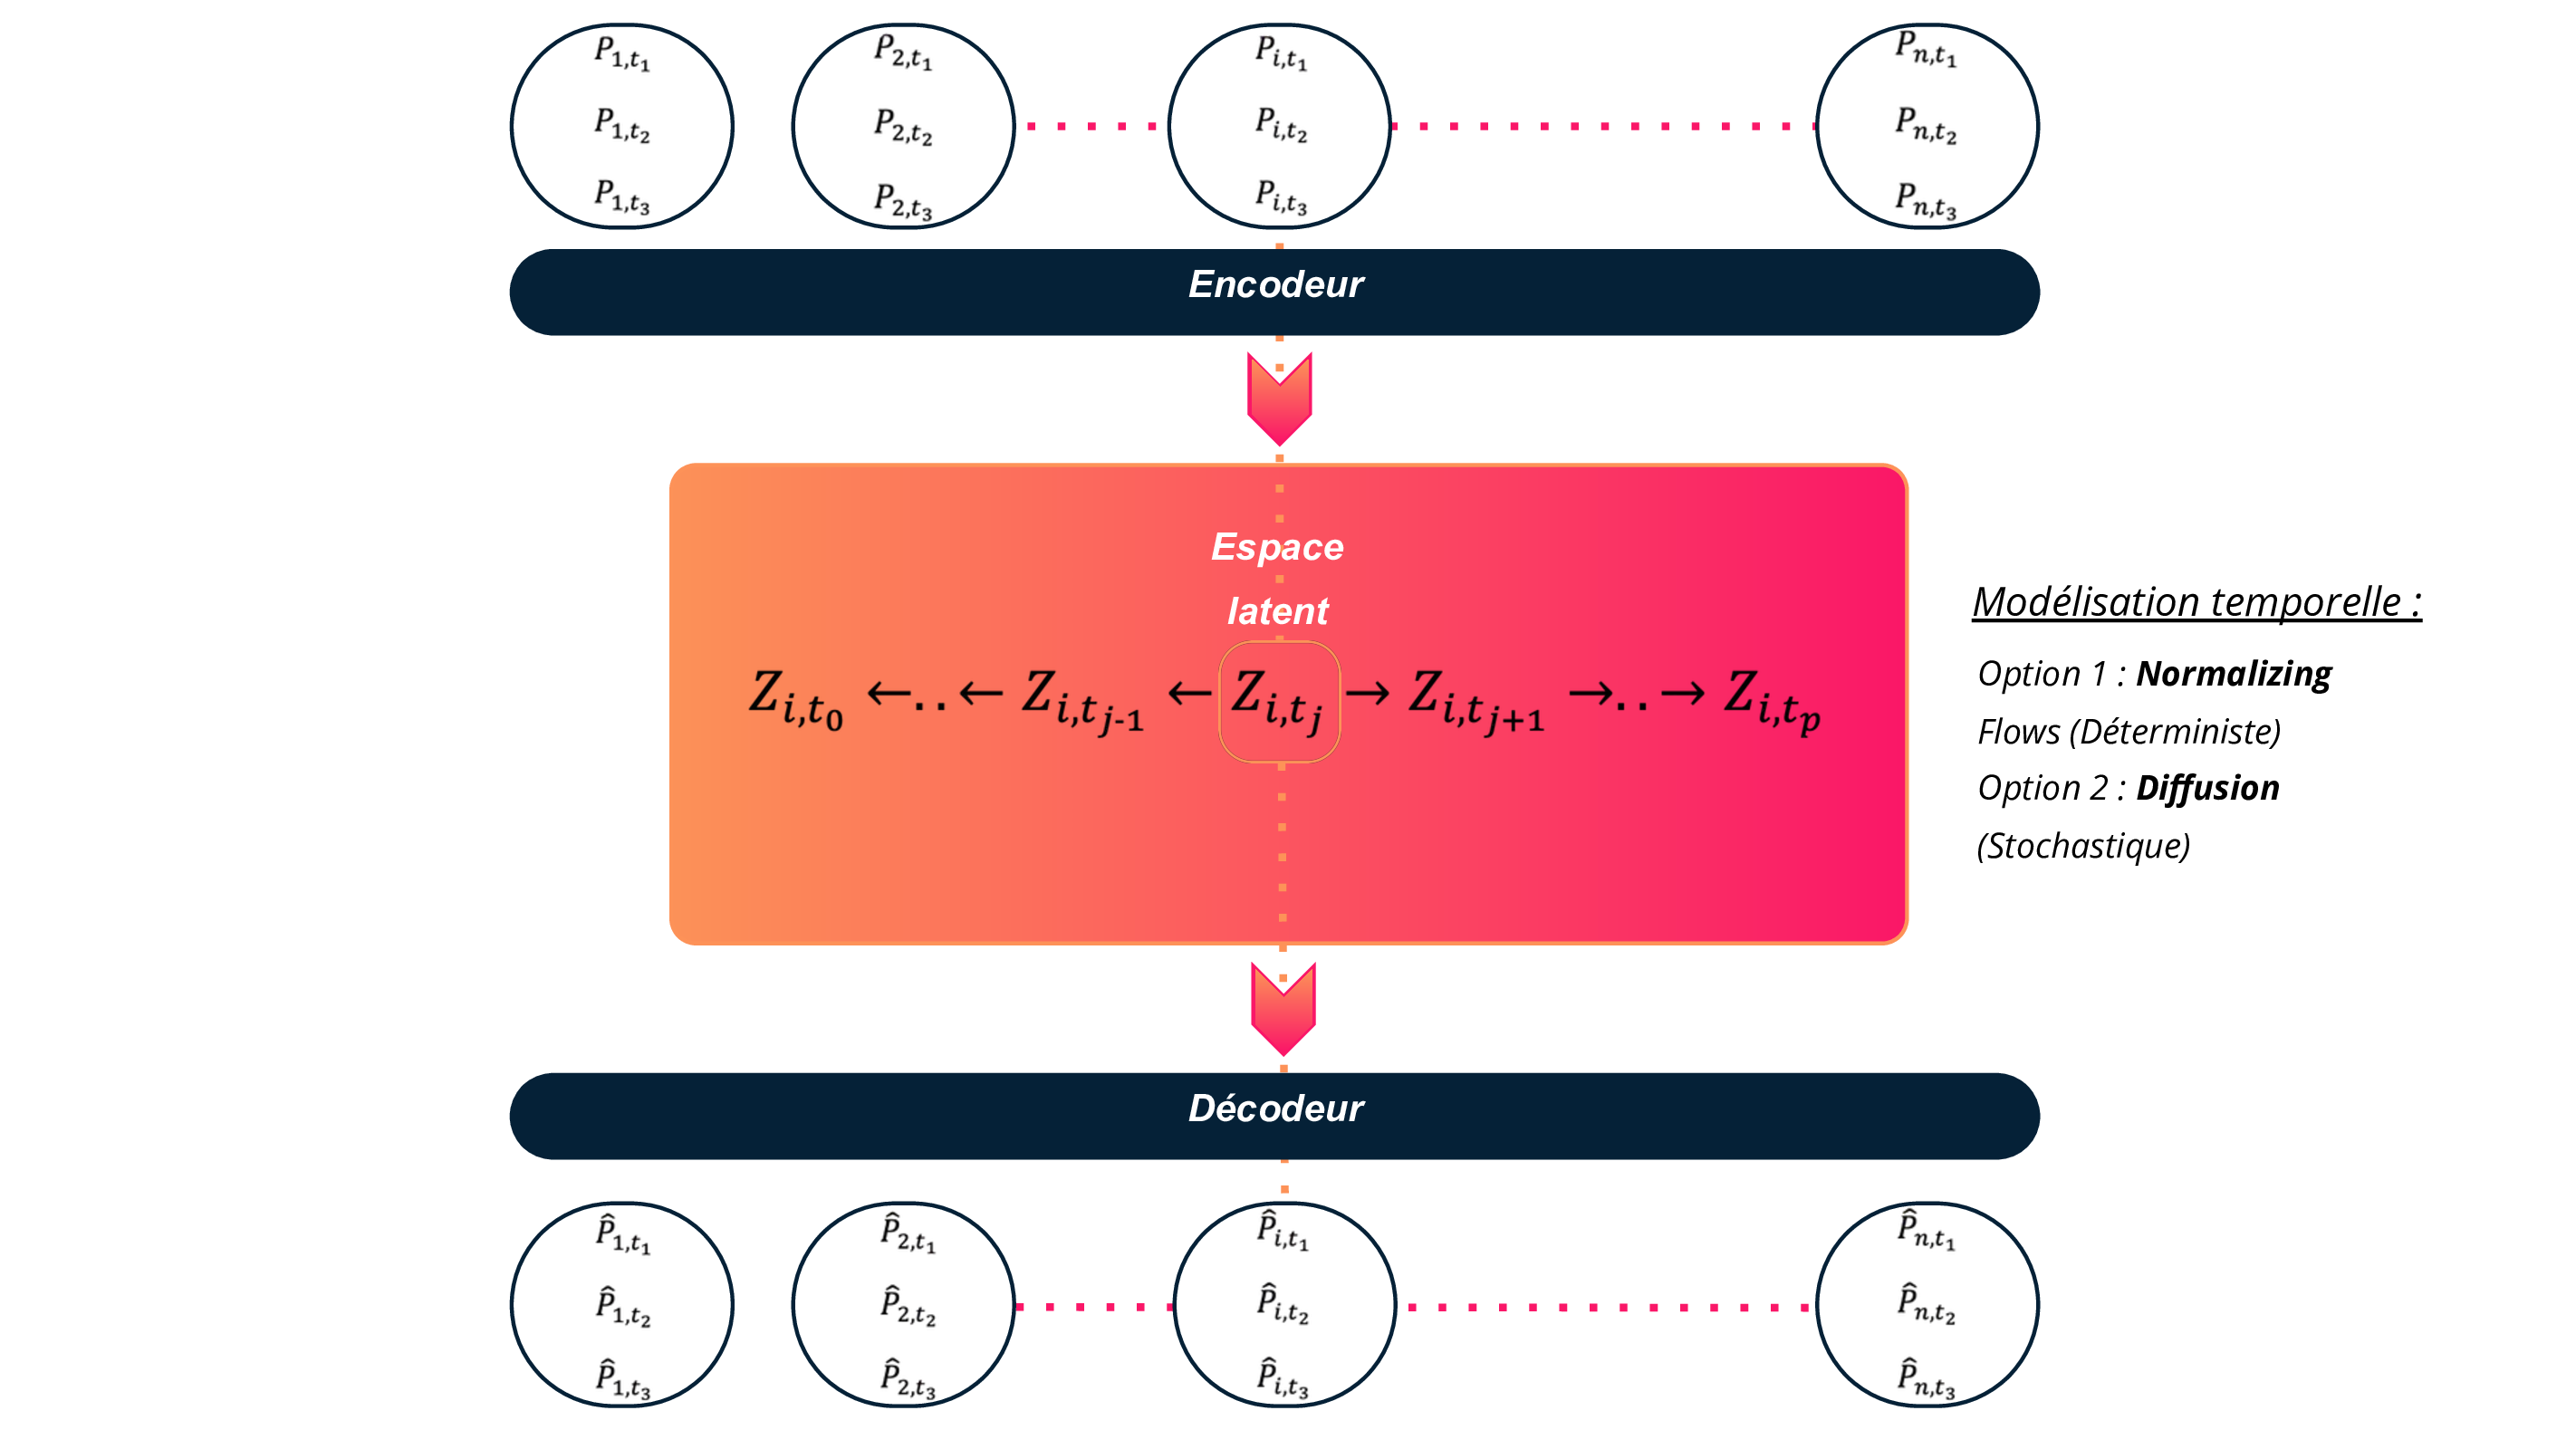
  • Modéliser des données longitudinales avec une approche temporelle, grâce à des extensions type Normalizing Flows ou Diffusion Models

En clair : on ne clone pas les données, on crée une nouvelle population artificielle crédible et diversifiée.

PATIENTS RÉELS VS PATIENTS ARTIFICIELS : QUELLE DIFFÉRENCE ?

Les patients artificiels générés par ORIGA :

  • Ne correspondent à aucun individu réel
  • Reproduisent fidèlement les propriétés statistiques des patients de départ
  • Peuvent être utilisés sans crainte de fuite de données ou de biais éthique
  • Permettent d’explorer des cas rares ou sous-représentés dans les cohortes réelles

Résultat : vous conservez toute la richesse des données cliniques, en éliminant les risques liés à leur usage.

FIABILITÉ, VALIDATION ET COMITÉ DE GARANTIE HUMAINE

Pour garantir la qualité et la pertinence des données générées, ORIGA intègre :
  • Une validation statistique rigoureuse (tests de Wasserstein, Kullback-Leibler, covariance, moments…)
  • Un comité de garantie humaine qui évalue la plausibilité clinique des patients artificiels
  • Un test de confidentialité qui vérifie qu’aucune donnée réelle ne peut être retrouvée ou inférée

COMITÉ SCIENTIFIQUE

Photo du Pr. Stéphanie Allassonnière

PR. STÉPHANIE ALLASSONNIÈRE

Professeure de Mathématiques Appliquées et Vice-Présidence Valorisation et partenariats industriels, Université Paris-Cité, Chaire et directrice adjointe de PR[AI]RIE, Co-fondatrice de Sonio

PR. VINCENT MINVILLE

Chef de pôle, anesthésiste-réanimateur, CHU de Toulouse
Photo du Dr. Fabrice Ferré

PR. FABRICE FERRE

Anesthésiste-Réanimateur, CHU de Toulouse

Photo du Pr. Bertrand Marcheix

PR. BERTRAND MARCHEIX

Chef du service de chirurgie cardiaque, CHU de Toulouse

VERS L’AVENIR DE LA RECHERCHE CLINIQUE

Logo France 2030

FRANCE 2030

BOTdesign est lauréat pour le programme France 2030 Export depuis 2025, marquant une étape clé dans son développement international. Le programme soutient l’exportation de technologies innovantes comme ORIGA, destinées à transformer le secteur de la santé. Grâce à cet appui, BOTdesign renforcera sa présence à l’étranger et développera de nouvelles collaborations stratégiques.

I-NOV

BOTdesign investit 1,4 M€ dans la R&D d’ORIGA, notre plateforme dédiée à la recherche clinique basée sur des patients artificiels. Ce projet, soutenu par un financement I-NOV dans le cadre de France 2030, est mené avec la Pr. Allassonnière de l’Université Paris Cité. Il vise à optimiser les modèles RHVAE pour générer des données médicales synthétiques tout en maintenant une approche éthique. Ce soutien positionne BOTdesign comme un futur leader européen des essais cliniques in silico.

Les Variational Autoencoders (VAEs) : Une innovation au service des données synthétiques

Les Variational Autoencoders (VAEs) sont des modèles génératifs profonds capables de créer des données synthétiques réalistes à partir de distributions apprises. En projetant les données d’entrée dans un espace latent structuré, puis en rééchantillonnant à partir de cet espace, les VAEs permettent de générer de nouvelles instances fidèles aux propriétés statistiques des données réelles.

Chez ORIGA, nous avons développé une gamme de VAEs adaptés à la diversité des données médicales et industrielles : imagerie, données tabulaires, séries temporelles, successions d’images, ou encore données multimodales. Notre expertise repose sur une personnalisation fine de l’espace latent et des mécanismes de génération en fonction du type de données.

Nos VAE intègrent plusieurs avancées clés :

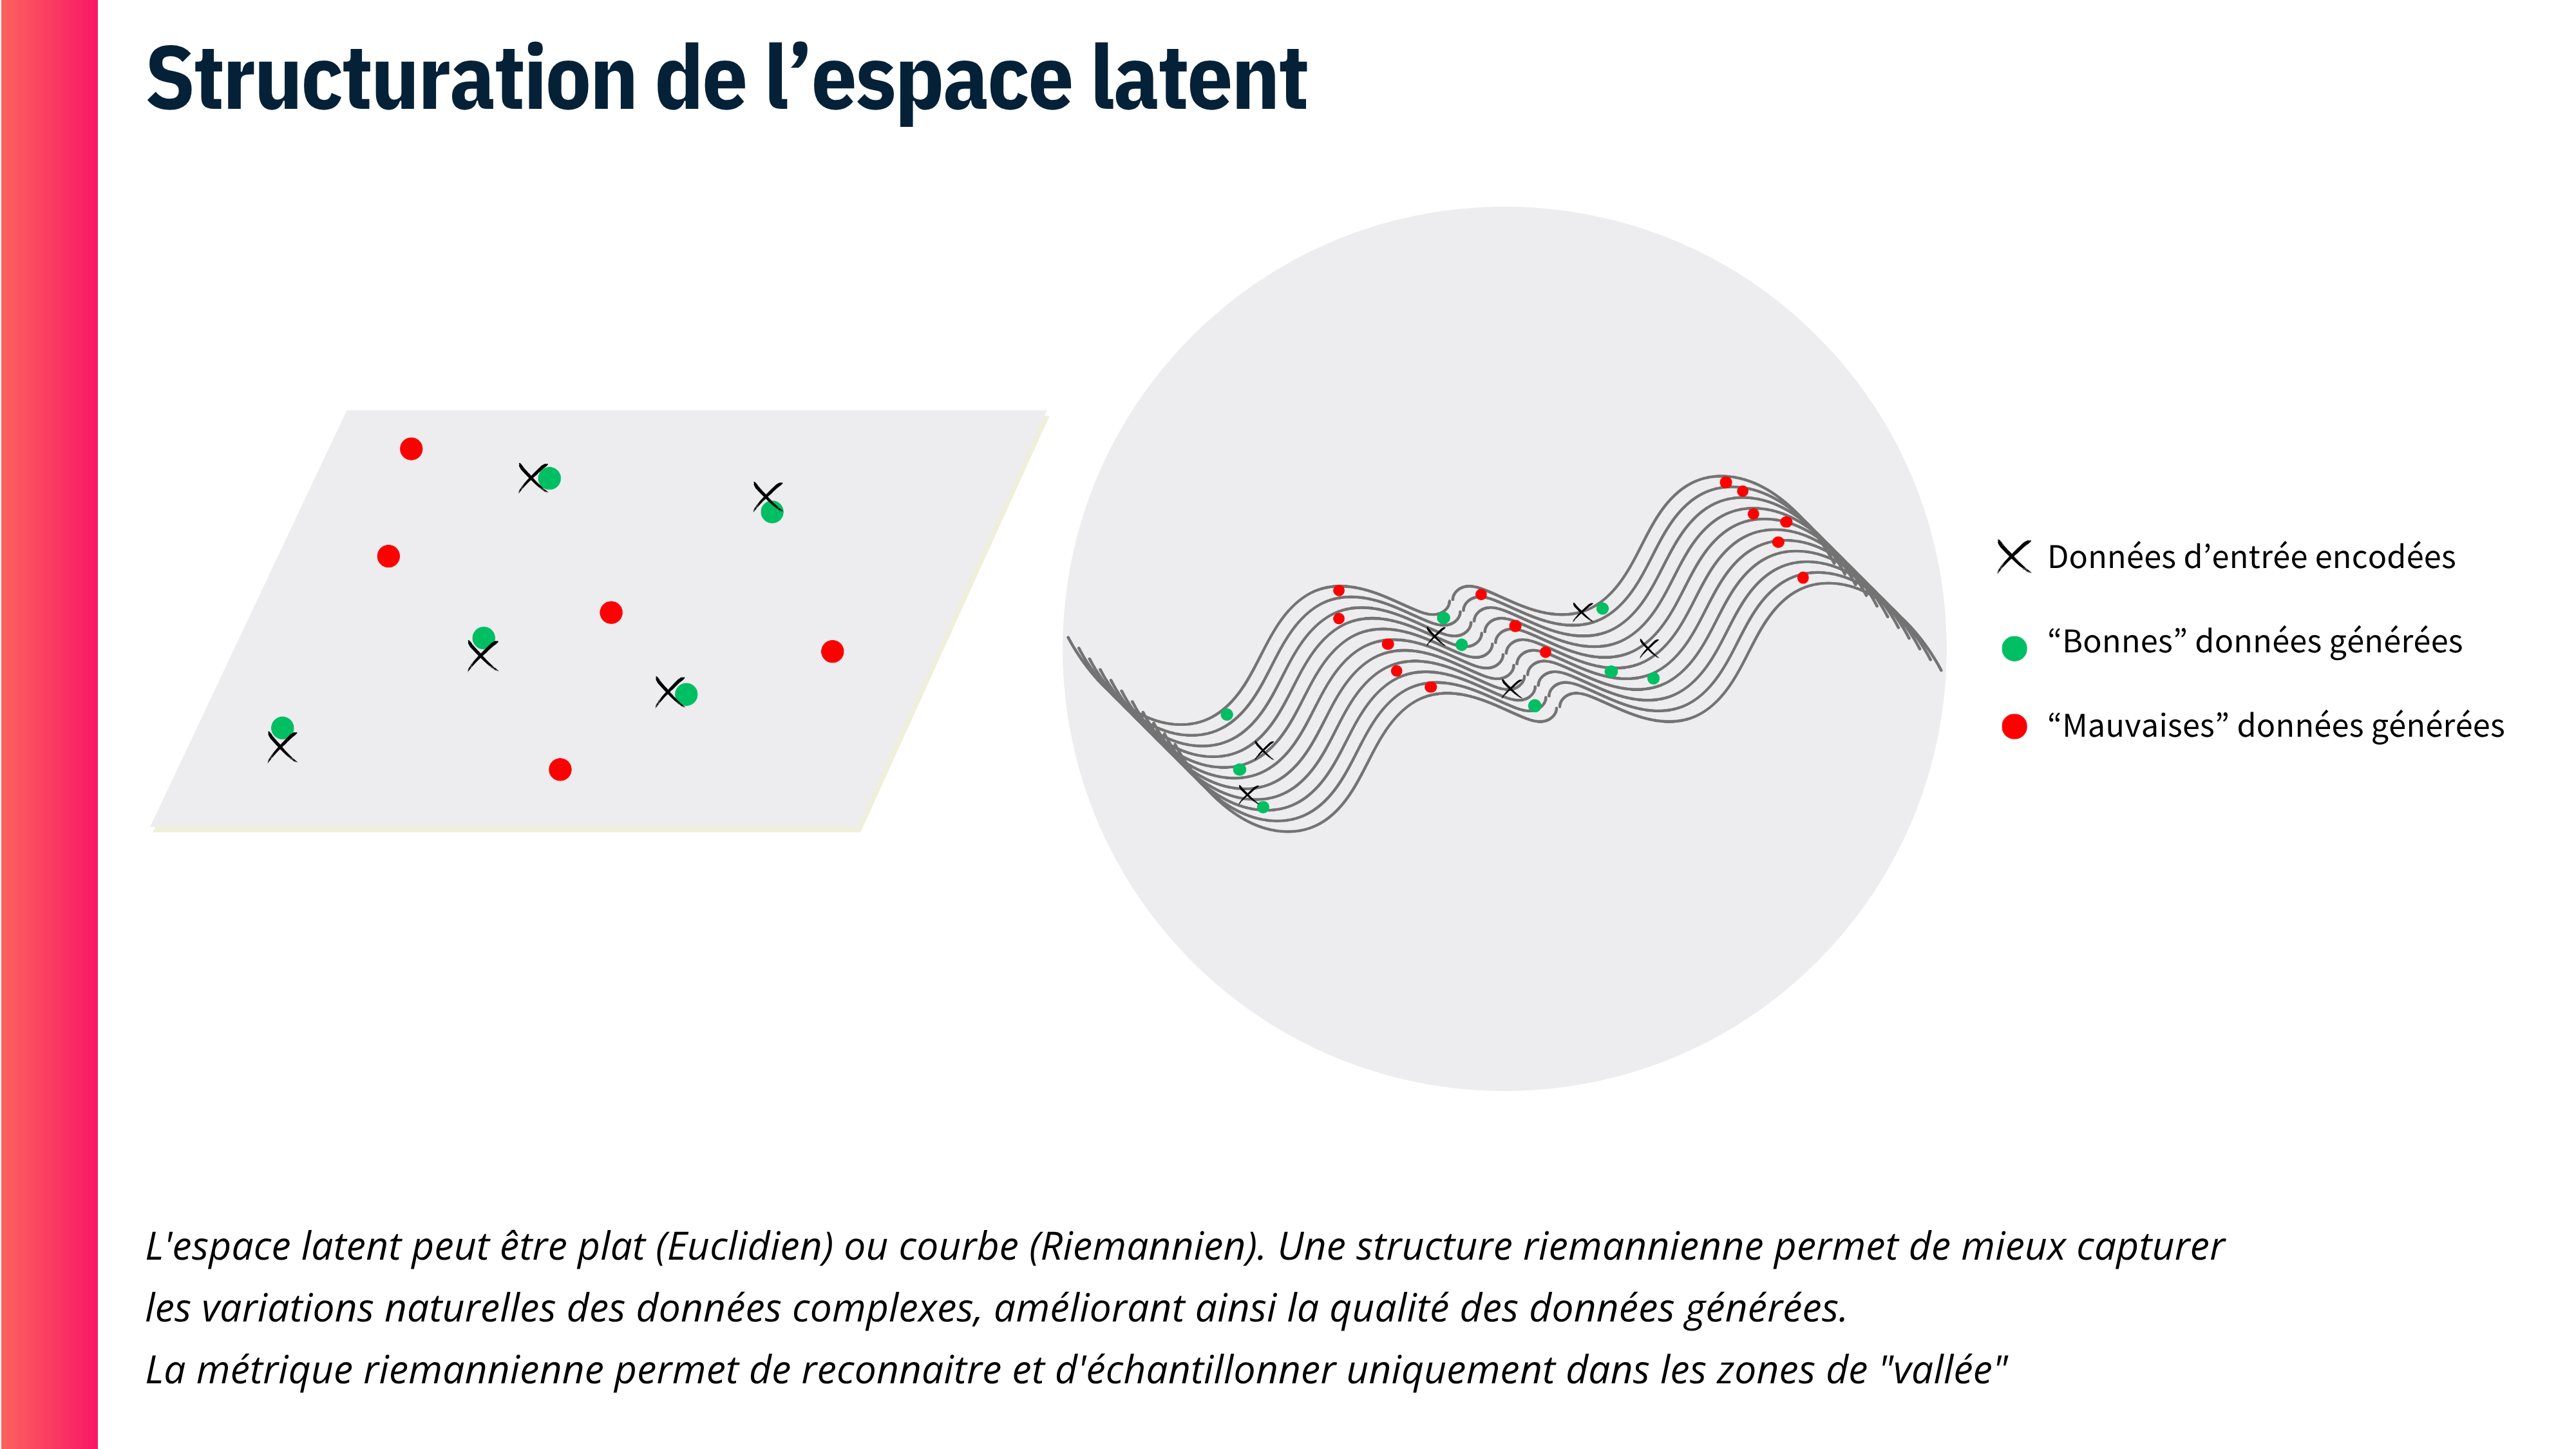
  • Espaces latents à géométrie riemannienne : Pour mieux capturer la complexité des structures de données réelles, nous structurons l’espace latent selon des variétés riemanniennes, au lieu d’un espace euclidien classique. Cela permet une modélisation plus fidèle des relations non linéaires et des contraintes inhérentes aux données.
  • Modèles pour données longitudinales : Pour les séries temporelles ou les séquences (comme l’évolution d’un patient au fil du temps), nous utilisons deux familles de modèles complémentaires :
    • Normalizing Flows, une approche déterministe qui transforme des distributions simples en distributions complexes, tout en garantissant une bijectivité. Cela permet un contrôle fin sur la dynamique temporelle des données.
    • Processus de Diffusion, une approche stochastique inspirée de la physique statistique, qui modélise la génération de données comme un processus inverse de bruitage progressif. Ces modèles permettent de capturer l’incertitude et la variabilité naturelle présente dans les trajectoires réelles.

Option 1 : Normalizing Flows – Évolution déterministe dans l’espace latent

Le modèle encode chaque observation dans une variable latente z_t.
Pour modéliser l’évolution temporelle, on n’impose pas la dynamique sur les images, mais directement sur les représentations latentes.
Grâce aux normalizing flows, une transformation fluide et inversible est appliquée à ces variables latentes pour capturer leur évolution dans le temps (zₜ₊₁ = fₜ(zₜ)).
Chaque z_t peut ensuite être décodé en une image x̂_t, assurant une continuité temporelle et une cohérence dans la séquence générée.

Option 2 : Processus de diffusion – Évolution stochastique dans l’espace latent

Plutôt que de transformer les représentations latentes de manière déterministe, le modèle peut apprendre à diffuser une variable latente à travers le temps en y ajoutant progressivement du bruit contrôlé.
On simule ainsi un processus inverse où, à partir d’un état bruité, on apprend à remonter vers des états plus clairs et structurés.
Ce mécanisme permet de capturer une dynamique stochastique et plus réaliste dans les séquences générées, tout en conservant la structure sous-jacente des données.

Grâce à cette combinaison de techniques avancées, nos modèles génèrent des données synthétiques robustes, interprétables et conformes aux exigences de qualité attendues dans les contextes sensibles, comme la santé ou la recherche clinique.

Dans les domaines biomédicaux, les données réelles issues de patients sont précieuses, mais souvent rares, sensibles, ou partiellement observées. Les patients artificiels sont des entités synthétiques, générées à partir de modèles statistiques ou algorithmiques, conçus pour reproduire les propriétés essentielles des patients réels tout en respectant les contraintes éthiques, légales et scientifiques.

Pourquoi générer des patients artificiels ?

  • Accroître la taille et la diversité des cohortes pour améliorer la robustesse des analyses.
  • Tester des scénarios rares ou anticiper des situations non encore observées.
  • Réduire les biais présents dans les données réelles.
  • Faciliter le partage de données dans des environnements réglementés.

Trois grandes familles de modèles pour générer des patients artificiels

1. Modèles bayésiens

  • Reposent sur des a priori explicites (connaissances métier, hypothèses cliniques) combinés aux données observées pour structurer la génération.
  • Permettent de modéliser l’incertitude de façon transparente, offrant une interprétabilité précieuse dans les contextes sensibles.
  • Particulièrement efficaces sur des petits jeux de données, ou lorsque la structure causale du phénomène est bien connue.

2. Modèles mécanistiques

  • Ces modèles reposent sur des équations différentielles ou des règles biologiques simulant les processus physiopathologiques (ex. : progression tumorale, réponse au traitement).
  • Très utiles pour tester des hypothèses mécanistiques ou simuler des effets d’interventions dans des cadres bien maîtrisés.
  • Leur limite : la difficulté de calibrer les paramètres et de capturer la variabilité interindividuelle.

3. Modèles de Deep Learning (IA générative)

  • Représentent l’état de l’art pour générer des patients synthétiques à partir de données riches et complexes (images, textes médicaux, séries temporelles, données multimodales).
  • Parmi eux, les Variational Autoencoders (VAEs), les GANs ou encore les modèles de diffusion permettent de générer des patients plausibles, diversifiés et adaptés à des cas d’usage ciblés (modélisation, simulation, entraînement de modèles).
  • Ces modèles capturent les structures latentes profondes des données, tout en intégrant les incertitudes et les dynamiques temporelles.

Ce que nous faisons chez ORIGA

Nos modèles d’IA générative ne visent pas à copier les patients réels, mais à créer des patients artificiels statistiquement plausibles, représentant la diversité des profils cliniques. Chaque patient généré est unique, sans correspondance directe dans les bases de données d’origine, garantissant la confidentialité tout en préservant la valeur analytique.
En intégrant des approches probabilistes (VAEs), géométriques (espaces latents riemanniens), et temporelles (flows et diffusion), notre technologie produit des cohortes artificielles cohérentes, fidèles, et adaptées aux besoins de recherche, de développement et de validation.

Cas d’usage concrets des patients artificiels

  • Recherche clinique & développement de traitements
    Générer des cohortes de patients artificiels pour simuler l’effet d’un traitement dans des sous-populations rares (ex. : jeunes patients avec comorbidités spécifiques), sans exposer de patients réels. Cela permet de tester des hypothèses, affiner les critères d’inclusion, ou anticiper des effets secondaires.
  • Renforcement de modèles prédictifs
    Enrichir des jeux de données réels souvent déséquilibrés (ex. : très peu de cas positifs dans des pathologies rares) avec des patients artificiels plausibles pour améliorer la performance des modèles de machine learning tout en réduisant les biais.
  • Validation de pipelines IA
    Créer des cas artificiels “contrôlés” avec des trajectoires cliniques spécifiques pour valider des outils d’aide au diagnostic ou de prédiction d’évolution. Cela permet de tester des modèles en dehors de leur distribution d’entraînement initiale.
  • Simulation de scénarios cliniques complexes
    Générer des trajectoires longitudinales complètes (ex. : imagerie d’évolution de la maladie, paramètres biologiques dans le temps) pour tester des protocoles ou comparer des stratégies thérapeutiques virtuellement, avant d’engager des essais cliniques coûteux.
  • Partage de données sans risque de ré-identification
    Créer des jumeaux artificiels de cohortes réelles pour permettre le partage avec des partenaires R&D, sans compromettre la vie privée des patients ni enfreindre les contraintes réglementaires.
  • Adaptation inter-populationnelle
    Générer des patients synthétiques correspondant à une population cible (ex. : transposer une cohorte européenne vers une population d’Asie de l’Est) afin d’évaluer l’adaptabilité d’un algorithme ou d’un dispositif médical.

Fiabilité, validation mathématique & comité de garantie humaine

Chez ORIGA, la génération de données artificielles repose sur des principes de rigueur scientifique, de traçabilité et de responsabilité. Afin de garantir la qualité des données synthétiques produites, nous avons mis en place un processus de validation en trois volets : fiabilité statistique, diversité des profils générés, et respect de la confidentialité. Ce processus combine des tests mathématiques formels avec une validation métier humaine.

Validation de la fiabilité statistique

Nos données artificielles doivent être statistiquement fidèles aux données réelles, sans pour autant en reproduire à l’identique les individus. Pour cela, plusieurs tests sont appliqués systématiquement :

  • Distance de Wasserstein (tests monovariés)
    Nous comparons chaque variable prise indépendamment entre la distribution réelle et la distribution générée.
    → Seuils : moyenne des distances < 5%, maximum < 10%.
  • Divergence de Kullback-Leibler (KL divergence, test multivarié)
    Nous évaluons la cohérence globale des distributions multivariées (toutes les variables combinées).
    → Seuil maximal fixé à 5%.
  • Analyse des moments & matrice de covariance
    Une étude complémentaire des moments statistiques (moyenne, variance, skewness, kurtosis) et de la structure des dépendances entre variables (via la matrice de covariance) permet de détecter d’éventuelles distorsions globales ou locales dans les données générées.

Validation par comité de garantie humaine

Les résultats des tests statistiques sont systématiquement complétés par une revue métier et médicale. Un comité de garantie humaine, composé d’experts du domaine (cliniciens, biostatisticiens, spécialistes métiers), analyse un échantillon de données synthétiques pour évaluer leur plausibilité, cohérence clinique, et utilité opérationnelle.
Cette approche hybride permet de concilier rigueur formelle et bon sens métier.

Validation de la diversité

Un bon modèle génératif ne se contente pas d’imiter les données d’origine — il doit produire des données nouvelles, réalistes et diversifiées, qui enrichissent l’espace des possibles tout en respectant les contraintes statistiques et cliniques.
Pour évaluer cette capacité de diversification, nous réalisons un test de collapse basé sur un protocole d’auto-régénération :

À partir d’un premier jeu de données générées artificiellement, nous réentraînons le modèle, puis nous générons un nouveau jeu de données. Ce processus est répété plusieurs fois.

Quel que soit le modèle utilisé, ce processus conduit inévitablement à un phénomène appelé collapse : au bout d’un certain nombre d’itérations, le modèle tend à générer de plus en plus de profils similaires, jusqu’à produire des données quasi-identiques d’un passage à l’autre.

Le test de diversité consiste donc à mesurer combien d’itérations successives peuvent être effectuées avant que ce collapse ne survienne de manière significative.
→ Plus le nombre d’itérations avant collapse est élevé, plus les données initialement générées sont diverses.

Cette mesure nous permet de quantifier la richesse et la capacité exploratoire du modèle, y compris dès la première génération. Elle est essentielle pour garantir que les cohortes synthétiques produites ne sont pas de simples variations superficielles, mais bien des représentations variées, couvrant de manière crédible les différentes configurations possibles d’un phénomène.

Validation de la confidentialité

La génération de données artificielles soulève une question essentielle : les données produites pourraient-elles, d’une manière ou d’une autre, permettre de remonter à un individu réel ? Pour garantir le respect du RGPD et la non-réidentifiabilité des patients, nous avons mis en place un test de confidentialité formel.

Ce test repose sur une idée simple : comparer la proximité entre un patient réel et les données générées.

Pour chaque individu réel, nous évaluons si son plus proche voisin parmi les données artificielles est plus proche que sa propre version reconstruite (c’est-à- dire encodée puis décodée par le modèle).

  • Si un patient réel est plus proche de sa propre reconstruction que de n’importe quel échantillon artificiel, cela indique que le modèle ne “recopie” pas ses caractéristiques précises dans les données générées.
  • En revanche, si le plus proche voisin est une donnée synthétique, cela pourrait suggérer une proximité problématique.

Nous considérons qu’il y a confidentialité garantie lorsque dans au moins 50% des cas, la donnée réelle est plus proche de sa reconstruction que de n’importe quel individu généré.
Ce test est un indicateur robuste de non-mémorisation par le modèle. Il complète les méthodes de régularisation et d’entraînement que nous utilisons pour éviter tout sur-apprentissage et tout risque de fuite d’information.